ایک PDF کو OCR کریں تاکہ ہر لفظ قابل تلاش ہو جائے
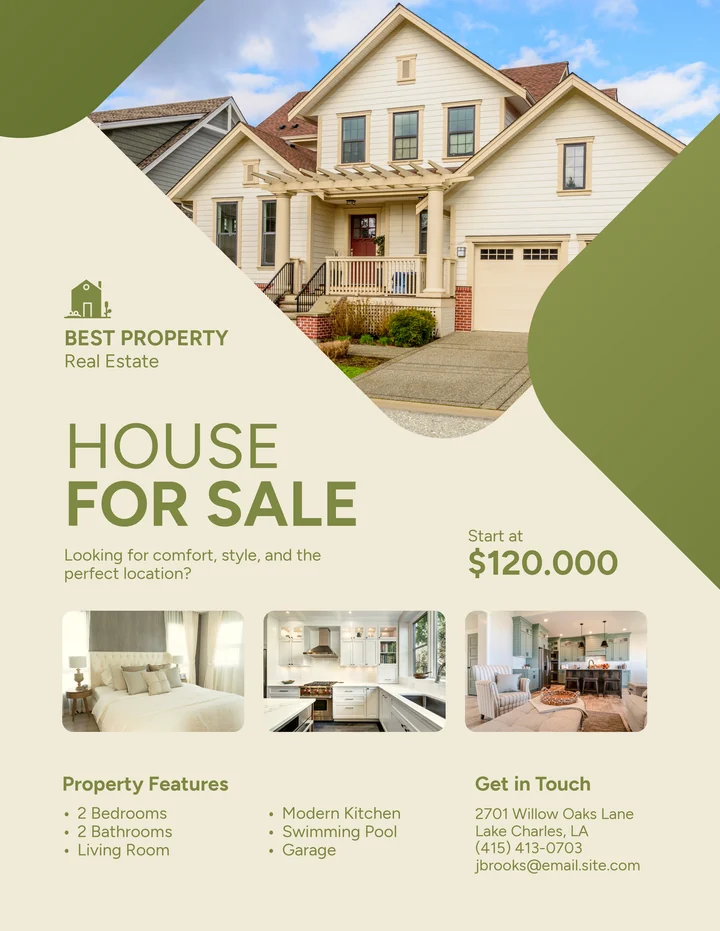
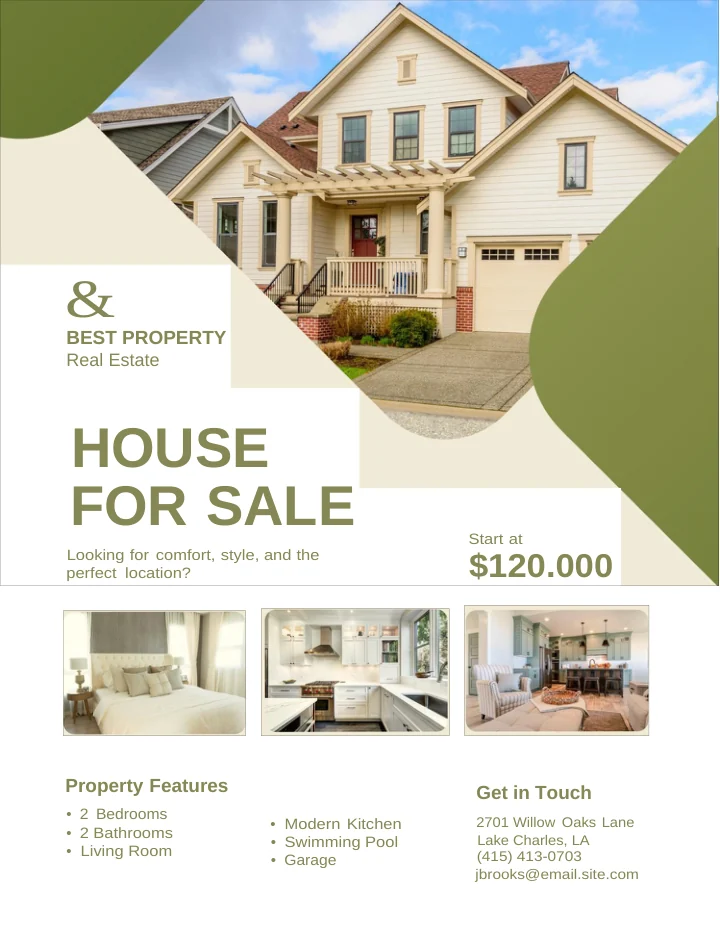
اسکین یا تصویر اپ لوڈ کریں — OCR خودکار طور پر قابل تلاش PDF بناتا ہے۔
عمومی سوالات
OCR PDF کے ساتھ کیا کرتا ہے؟
یہ اسکین شدہ صفحے کے پیچھے ایک متن کی تہہ شامل کرتا ہے، تاکہ آپ الفاظ کو تلاش، منتخب اور کاپی کر سکیں جبکہ صفحہ ابھی بھی اصل اسکین کی طرح لگتا ہے۔
کیا میں PDF کی بجائے تصویر اپ لوڈ کر سکتا ہوں؟
ہاں۔ JPG، PNG، TIFF، BMP اور WebP تصویروں کو ایک PDF میں شامل کر کے ایک ہی بار میں OCR کے ساتھ پڑھا جا سکتا ہے۔
میں کیسے جان سکتا ہوں کہ میری PDF کو OCR کی ضرورت ہے؟
ایک جملہ منتخب کرنے کی کوشش کریں۔ اگر کچھ بھی نمایاں نہ ہو تو صفحہ ایک تصویر ہے۔ آپ کو پہلے فیصلہ کرنے کی ضرورت نہیں ہے — تبدیلی کی پائپ لائن خود بخود ٹیکسٹ کی تہہ کی جانچ کرتی ہے۔
کیا نتیجہ واقعی قابل تلاش ہے؟
ہاں۔ اس صفحے کے لیے قبولیت کی جانچ تیار شدہ PDF سے متن نکالتی ہے بجائے اس کے کہ صرف یہ مان لیا جائے کہ OCR ٹول نے کام کیا۔
کیا یہ صفحات کی شکل کو بدل دے گا؟
نظر آنے والا اسکین شدہ صفحہ اپنی جگہ پر رہتا ہے جبکہ ایک غیر مرئی ٹیکسٹ لیئر شامل کی جاتی ہے۔ ہاتھ کی لکھائی، دھندلاہٹ یا بہت چھوٹی چھپائی پر شناخت ناقص ہو سکتی ہے۔
PDF کتنی بڑی ہو سکتی ہے؟
10 MB تک۔ 20 صفحات سے زیادہ دستاویزات کو ان کے پہلے 20 صفحات تک پروسیس کیا جاتا ہے — ادائیگی والے اکاؤنٹ پر 100 — اور نتیجہ رپورٹ کرتا ہے کہ یہ کب ہوا۔
کیا میں اس کے بجائے Word فائل حاصل کر سکتا ہوں؟
ہاں۔ آؤٹ پٹ کنٹرول میں Word منتخب کریں اور اسکین کو ایک قابلِ ترمیم DOCX دستاویز کے طور پر دوبارہ بنایا جاتا ہے۔
کیا OCR کو مفت آزمایا جا سکتا ہے؟
ہاں۔ آپ کی پہلی OCR تبدیلی بغیر اکاؤنٹ کے چل سکتی ہے۔
کیا کوئی واٹر مارک ہے؟
نہیں۔ قابلِ تلاش PDF پر واٹر مارک نہیں لگایا جاتا۔
کیا اوپر دی گئی مثال اصلی ہے؟
ہاں۔ یہ تبدیلی کی خصوصیت کے صفحے پر دکھایا گیا حقیقی تصویر سے دستاویز کے OCR نتیجے کا استعمال کرتا ہے۔