ធ្វើ OCR លើ PDF ដើម្បីឱ្យគ្រប់ពាក្យទាំងអស់អាចស្វែងរកបាន
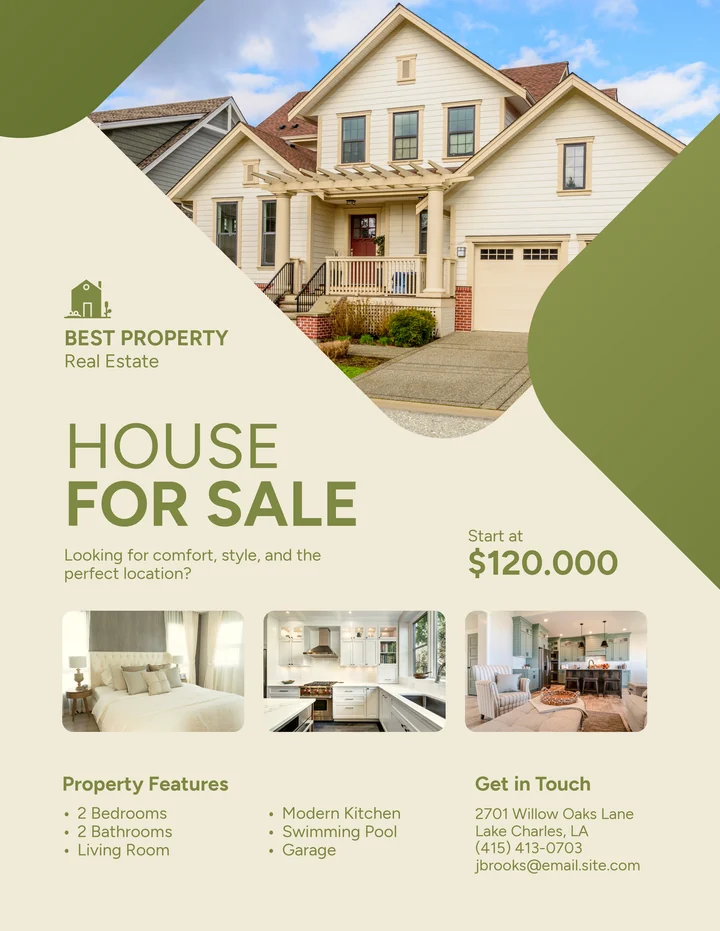
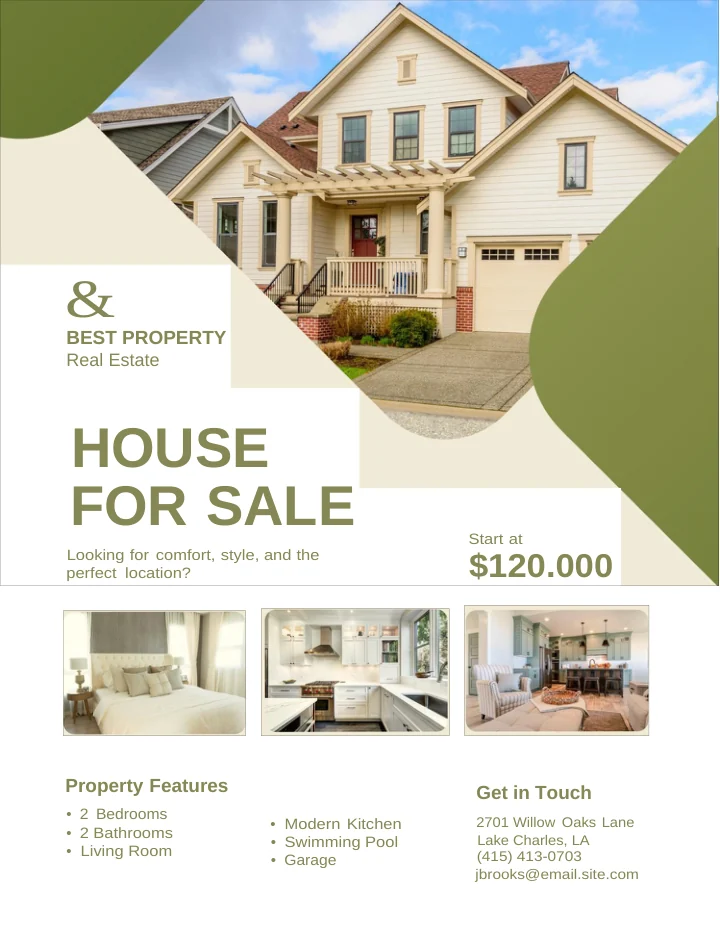
បង្ហោះរូបស្កេន ឬរូបភាព — OCR នឹងបង្កើត PDF ដែលអាចស្វែងរកអត្ថបទបានដោយស្វ័យប្រវត្តិ។
សំណួរដែលសួរជាញឹកញាប់
តើ OCR ធ្វើអ្វីខ្លះទៅលើ PDF?
វាបន្ថែមស្រទាប់អត្ថបទនៅពីក្រោយទំព័រដែលបានស្កេន ដូច្នេះអ្នកអាចស្វែងរក ជ្រើសរើស និងចម្លងពាក្យបាន ខណៈពេលដែលទំព័រនៅតែមានរូបរាងដូចរូបភាពស្កេនដើម។
តើខ្ញុំអាចផ្ទុករូបភាពជំនួសឱ្យ PDF បានឬ?
បាទ។ រូបភាព JPG, PNG, TIFF, BMP និង WebP អាចត្រូវបានបញ្ចូលទៅក្នុង PDF និងអានជាមួយ OCR ក្នុងការដំណើរការតែមួយលើក។
តើខ្ញុំដឹងដោយរបៀបណាថា PDF របស់ខ្ញុំត្រូវការ OCR?
ព្យាយាមជ្រើសរើសប្រយោគមួយ។ ប្រសិនបើគ្មានអ្វីត្រូវបានរំលេចទេ ទំព័រនោះគឺជារូបភាព។ អ្នកមិនចាំបាច់សម្រេចចិត្តមុនឡើយ — ដំណើរការបម្លែងនឹងពិនិត្យមើលស្រទាប់អត្ថបទដោយស្វ័យប្រវត្តិ។
តើលទ្ធផលពិតជាអាចស្វែងរកបានមែនទេ?
បាទ/ចាស។ ការពិនិត្យទទួលយកសម្រាប់ទំព័រនេះ គឺទាញយកអត្ថបទចេញពី PDF ដែលបានបង្កើត ជំនួសឱ្យការទុកចិត្តត្រឹមតែថាឧបករណ៍ OCR ត្រូវបានដំណើរការ។
តើវានឹងផ្លាស់ប្តូររូបរាងទំព័រដែរឬទេ?
ទំព័រដែលបានស្កែនដែលមើលឃើញនៅតែដដែល ខណៈពេលដែលស្រទាប់អត្ថបទដែលមើលមិនឃើញត្រូវបានបន្ថែម។ ការសម្គាល់អាចមិនល្អឥតខ្ចោះលើអក្សរដៃ អត្ថបទស្រពោន ឬអក្សរតូចខ្លាំង។
PDF អាចមានទំហំប៉ុណ្ណាដែរ?
រហូតដល់ 10 MB ។ ឯកសារដែលវែងជាង 20 ទំព័រត្រូវបានដំណើរការរហូតដល់ 20 ទំព័ររបស់ពួកគេ — 100 នៅលើគណនីបង់ប្រាក់ — ហើយលទ្ធផលរាយការណ៍ពេលដែលវាបានកើតឡើង។
តើខ្ញុំអាចទទួលបានជាឯកសារ Word ជំនួសវិញបានដែរឬទេ?
បាទ។ ជ្រើសរើស Word ក្នុងប្រអប់ជ្រើសរើសទម្រង់លទ្ធផល ហើយការស្កេននឹងត្រូវបានបង្កើតឡើងវិញជាឯកសារ DOCX ដែលអាចកែសម្រួលបាន។
តើ OCR អាចសាកល្បងដោយឥតគិតថ្លៃដែរឬទេ?
បាទ/ចាស។ ការបំប្លែង OCR លើកដំបូងរបស់អ្នកអាចដំណើរការបានដោយមិនបាច់មានគណនីនោះទេ។
តើមានរូបសញ្ញាទឹក (watermark) ដែរឬទេ?
ទេ។ PDF ដែលអាចស្វែងរកបាន គឺមិនមានជាប់រូបសញ្ញាទឹក (Watermark) ទេ។
តើឧទាហរណ៍ខាងលើជាការបម្លែងពិតប្រាកដមែនទេ?
បាទ។ វាប្រើប្រាស់លទ្ធផល OCR រូបភាពទៅជាឯកសារពិតប្រាកដ ដែលបានបង្ហាញនៅលើទំព័រមុខងារបំប្លែង។