スキャンしたPDFの表を実際のスプレッドシートに変換
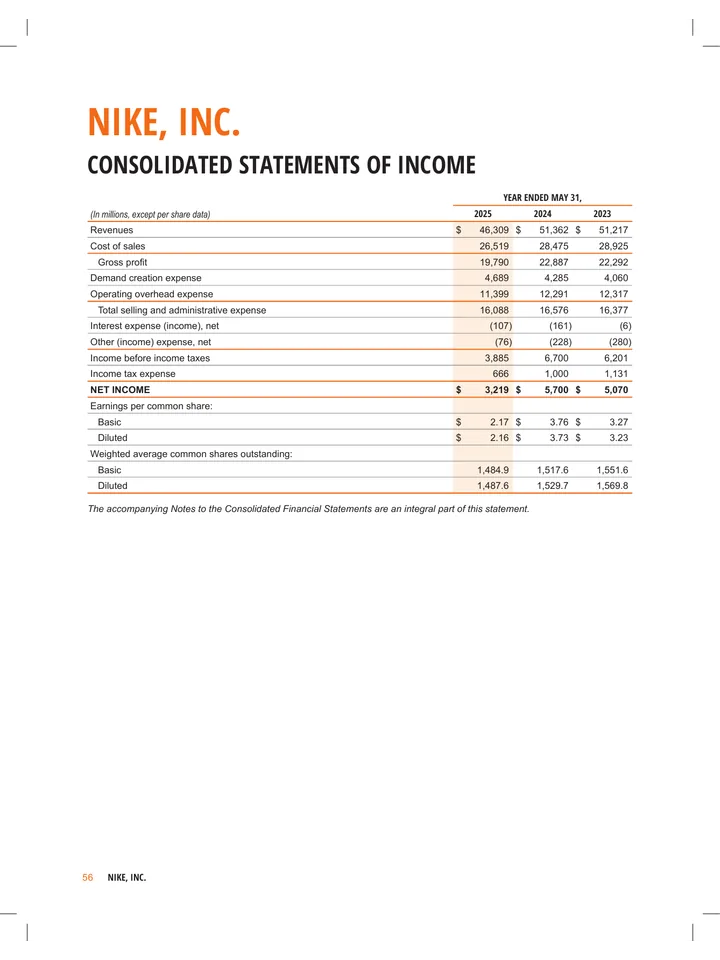
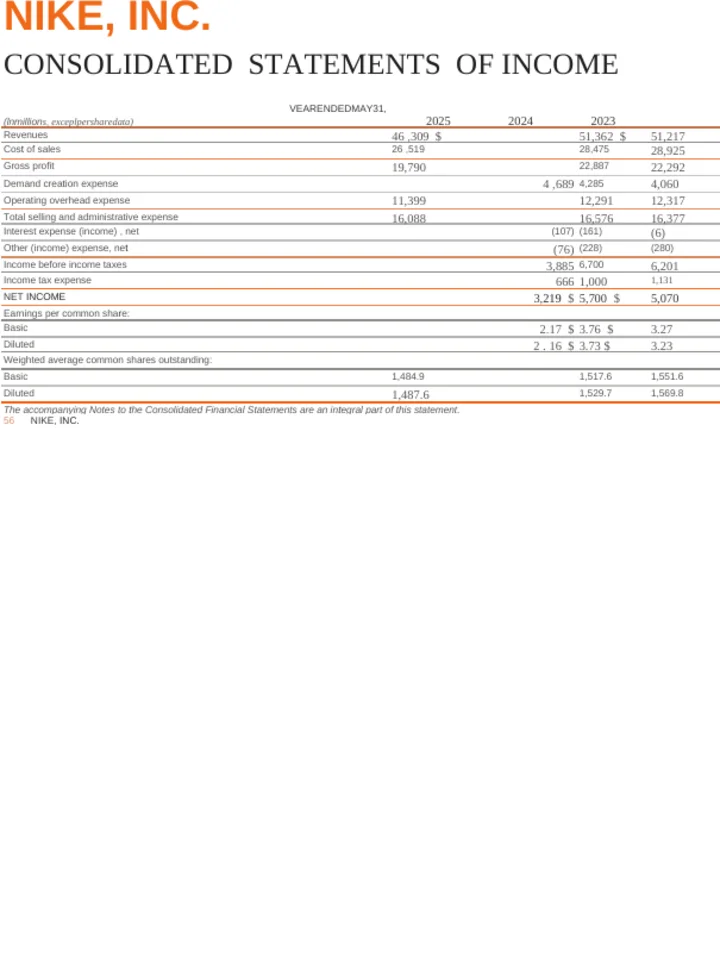
スキャンしたPDFをアップロードすると、テキストレイヤーがない場合は文字認識が自動的に実行されます。
よくある質問
数値は実際のセルに入りますか?
はい。表は画像として貼り付けられるのではなく、1つのセルに1つの値が入ったスプレッドシートとして再構築されます。すぐに並べ替え、合計、グラフ作成ができます。
後で数値を確認したほうがよいですか?
はい、必ず確認してください。ここにある数字はすべてページ画像から読み取ったもので、かすれた3が8と認識されることもあります。認識精度は非常に高いものの、確実ではありません。結果を使用する前に、合計を確認してください。
OCRを有効にする必要がありますか?
いいえ。まずすべてのPDFがチェックされ、テキストレイヤーがない場合は文字認識が自動的に実行されます。スプレッドシートへの書き出しでは、ページ上の情報が少なすぎて読み取れず、処理が停止する可能性がある場合にも文字認識が実行されます。
その後もここでスプレッドシートの編集を続けることはできますか?
いいえ。始める前に知っておくべき重要な点です。当サービスでは、スプレッドシートへの変換が最終工程となります。スプレッドシートには変換できますが、その後、その内容を翻訳したり書き換えたりすることはできません。内容にも手を加えたい場合は、まずWordに変換し、最後にExcelへ変換してください。
通常の変換より時間がかかるのはなぜですか?
スプレッドシートを作成する前に、すべてのページを画像として読み取るためです。この処理には実際に時間がかかるため、スキャン画像は、すでにテキストが含まれているPDFよりも処理に時間がかかります。
変換に適したスキャン画像の条件は何ですか?
傾きがなく、罫線がはっきり見える高解像度のスキャンが適しています。列は罫線によって区別されるため、不鮮明なスキャンや傾いたスキャンでは、数字が読み取れなくなるより先に列構造が失われます。
PDFの長さに制限はありますか?
ファイルあたり最大10MB。20ページを超えるドキュメントは最初の20ページまで処理されます(有料アカウントでは100ページまで)。この制限が適用された場合は、結果にその旨が表示されます。
表ではないページはどうなりますか?
通常の文章は破棄されず、テキストの行として取り込まれます。PDFの大部分が文章で、表が1つだけ含まれている場合は、Wordに変換したほうが読みやすくなります。
処理結果に透かし(ウォーターマーク)は追加されますか?
いいえ。どのアカウントレベルでも、変換されたファイルに透かしが入ることはありません。
アカウントは必要ですか?
いいえ。最初の変換はサインアップなしで実行されます。