对 PDF 执行 OCR,让每个词都可搜索
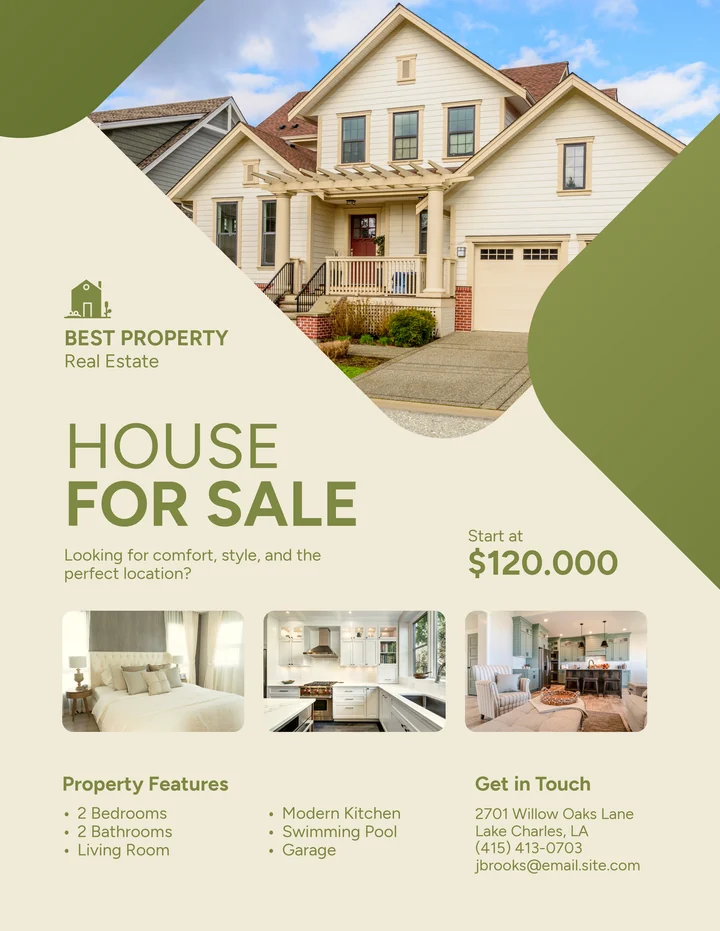
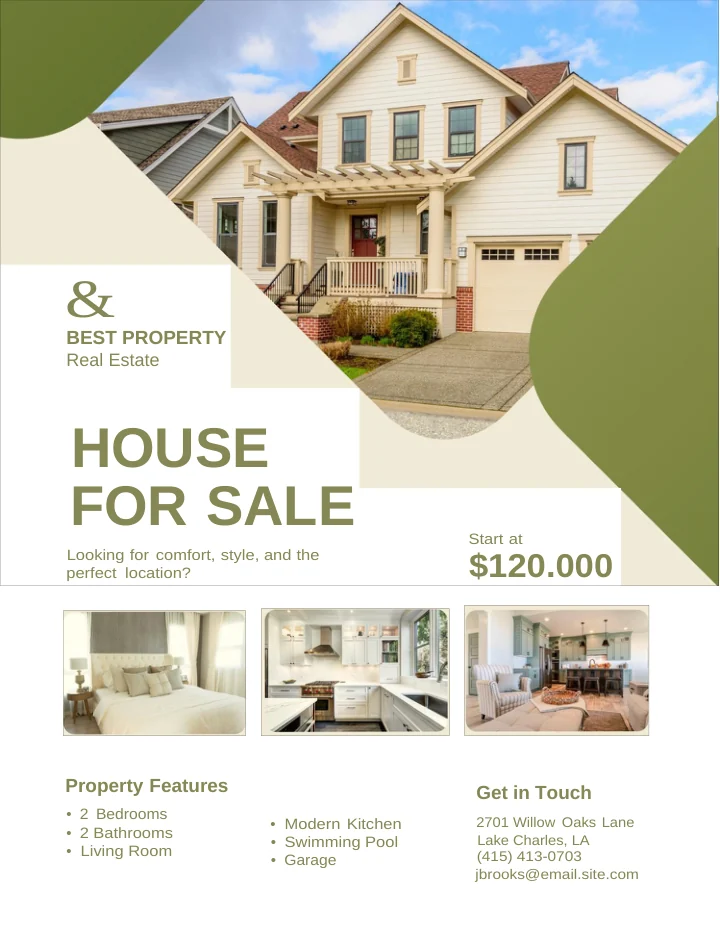
上传扫描件或图片——OCR 会自动生成可搜索的 PDF。
常见问题
OCR 对 PDF 做什么?
它会在扫描页面后方添加文本层,因此您可以搜索、选择和复制文字,同时页面看起来仍与原始扫描相同。
我能否上传图像而不是 PDF?
可以。JPG、PNG、TIFF、BMP 和 WebP 图片可转为 PDF,并在同一次运行中使用 OCR 读取。
我如何知道我的 PDF 是否需要 OCR?
尝试选择一个句子。如果没有任何内容高亮,说明该页面是图片。您不需要先做出判断——转换流程会自动检查是否有文本层。
结果真的可以搜索吗?
是。此页面的验收检查会从生成的 PDF 中提取文字,而不是仅凭 OCR 工具已运行就视为成功。
它会改变页面的外观吗?
可见的扫描页面保持不动,同时添加不可见的文本层。对于手写、模糊或非常小的文本,识别可能不完美。
PDF 可以有多大?
最多 10 MB。超过 20 页的文档会处理到前 20 页——付费账户最多 100 页——结果会注明是否发生了此情况。
我能否改为取得 Word?
是的。在输出控制中选择 Word,扫描将重建为可编辑的 DOCX 文件。
OCR 是否可以免费试用?
是。您的第一次 OCR 转换可以在没有账户的情况下运行。
是否有水印?
不会。可搜索的 PDF 没有水印。
上面的例子是否真实?
是的。它使用的是转换功能页面上展示的真实图片转文档 OCR 结果。