Распознавание текста в PDF, чтобы каждое слово можно было искать
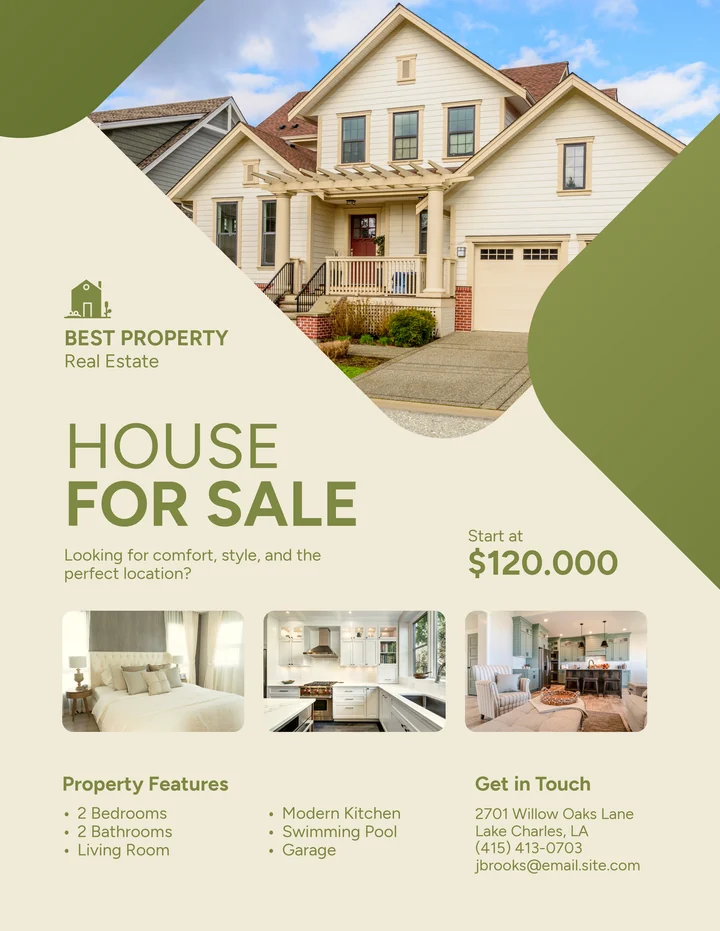
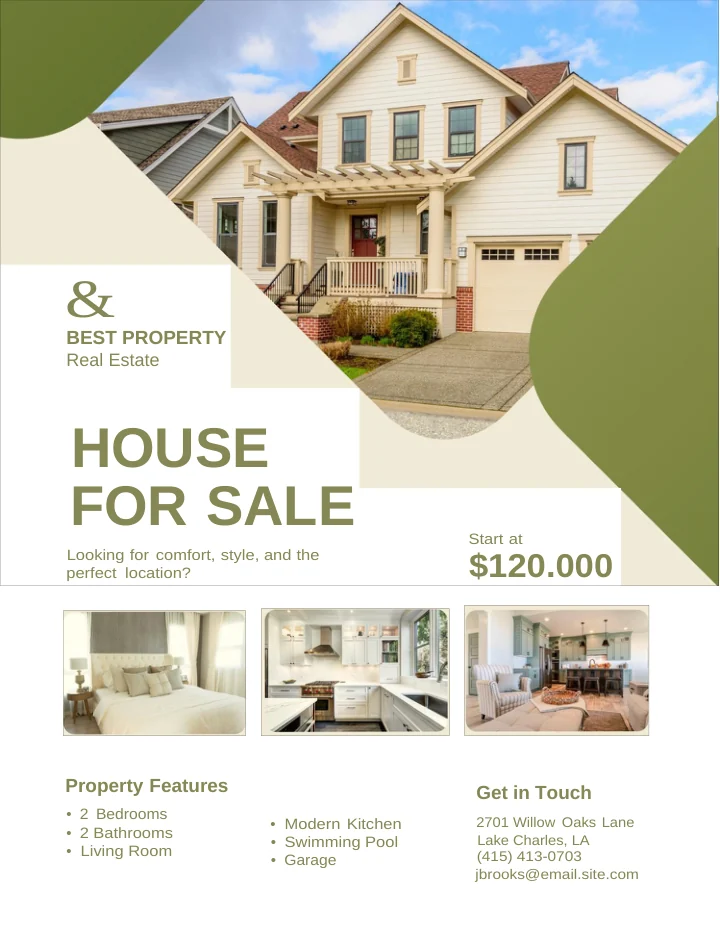
Загрузите скан или изображение — OCR автоматически создаёт доступный для поиска PDF.
Часто задаваемые вопросы
Что OCR делает с PDF?
Он добавляет текстовый слой под отсканированной страницей, чтобы вы могли искать, выделять и копировать слова, а страница по-прежнему выглядит как исходный скан.
Могу ли я загрузить изображение вместо PDF?
Да. Изображения JPG, PNG, TIFF, BMP и WebP можно обернуть в PDF и прочитать с помощью OCR в один проход.
Как узнать, нужна ли моему PDF функция OCR?
Попробуйте выделить предложение. Если ничего не выделится, страница является изображением. Вам не нужно решать заранее — конвейер преобразования автоматически проверяет наличие текстового слоя.
Можно ли в результате действительно искать по тексту?
Да. Приёмочная проверка для этой страницы извлекает текст из полученного PDF, а не полагается на то, что инструмент OCR просто запустился.
Изменится ли внешний вид страниц?
Видимая отсканированная страница остаётся на месте, а невидимый текстовый слой добавляется сверху. Распознавание может быть неточным при наличии рукописного текста, размытости или очень мелкого шрифта.
Какой максимальный размер может быть у PDF?
До 10 МБ. Документы длиннее 20 страниц обрабатываются до первых 20 страниц — 100 на платном аккаунте — и результат сообщает вам, когда это произошло.
Могу ли я получить Word вместо этого?
Да. Выберите Word в настройке формата вывода, и скан будет восстановлен как редактируемый документ DOCX.
Можно ли попробовать OCR бесплатно?
Да. Ваше первое преобразование OCR может работать без учетной записи.
Есть ли водяной знак?
Нет. Файл PDF с возможностью поиска не имеет водяного знака.
Является ли приведённый выше пример подлинным?
Да. Он использует результат реального OCR преобразования изображения в документ, показанный на странице функции преобразования.