Lav en PDF om med OCR, så hvert ord kan søges i
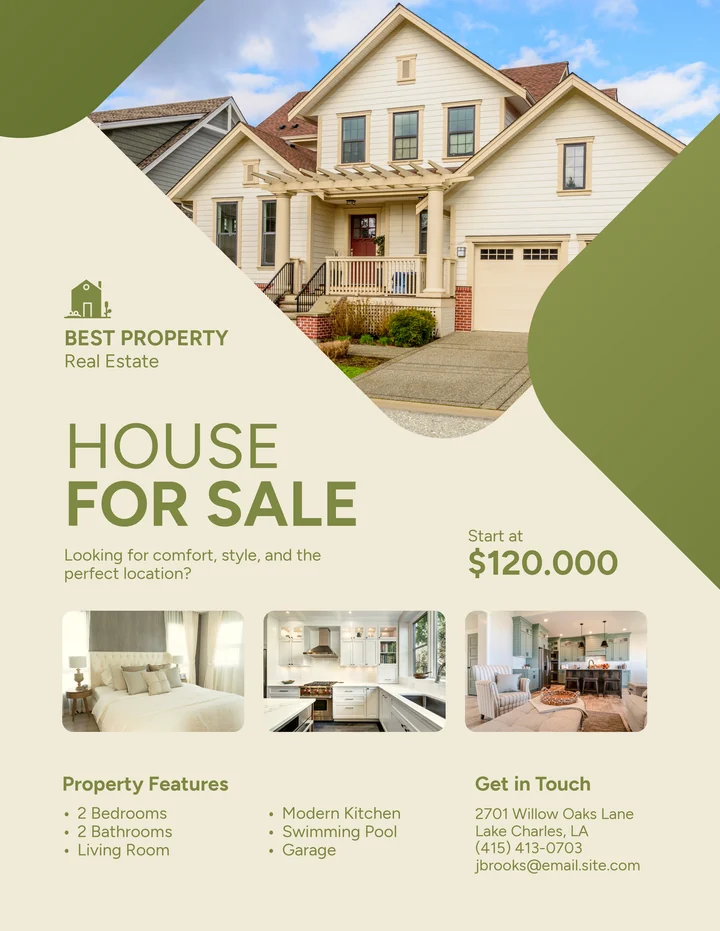
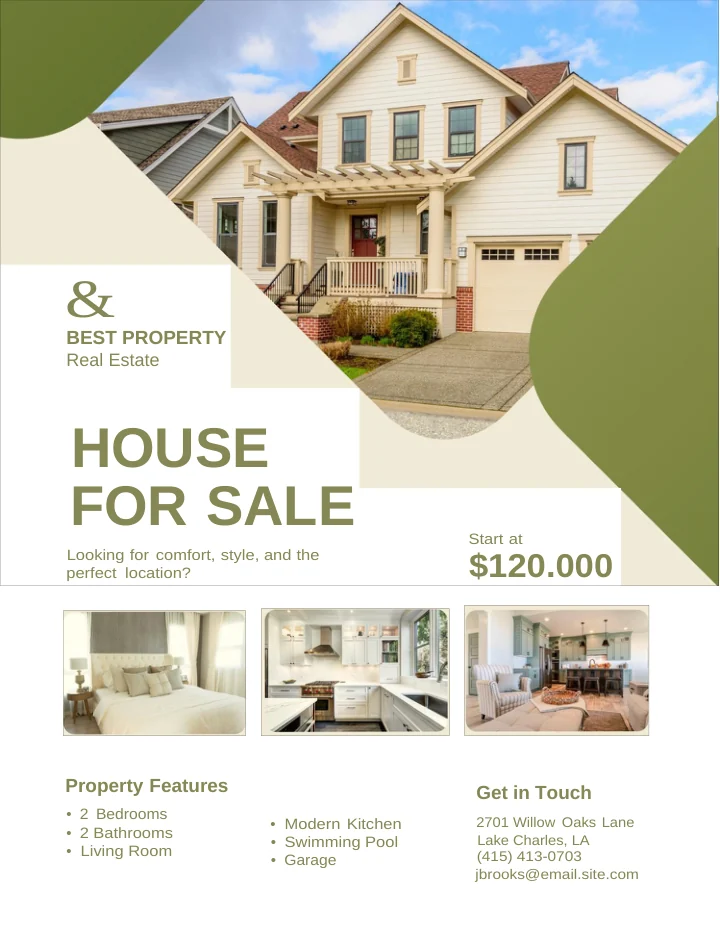
Upload en scanning eller et billede – OCR laver automatisk en PDF, der kan søges i.
Almindelige spørgsmål
Hvad gør OCR ved en PDF?
Det tilføjer et tekstlag bag den scannede side, så du kan søge, markere og kopiere ord, mens siden stadig ser ud som den oprindelige scanning.
Kan jeg uploade et billede i stedet for en PDF?
Ja. JPG-, PNG-, TIFF-, BMP- og WebP-billeder kan pakkes ind i en PDF og læses med OCR i samme kørsel.
Hvordan ved jeg, om min PDF har brug for OCR?
Prøv at markere en sætning. Hvis intet fremhæves, er siden et billede. Du behøver ikke afgøre det først – konverteringen kontrollerer automatisk for et tekstlag.
Kan resultatet virkelig søges i?
Ja. Godkendelsestjekket for denne side udtrækker tekst fra den producerede PDF i stedet for blot at stole på, at et OCR-værktøj er kørt.
Ændrer det, hvordan siderne ser ud?
Den synlige scannede side bliver på plads, mens et usynligt tekstlag tilføjes. Genkendelsen kan være ufuldkommen ved håndskrift, sløring eller meget lille skrift.
Hvor stor må PDF'en være?
Op til 10 MB. Dokumenter med mere end 20 sider behandles til og med de første 20 sider – 100 på en betalingskonto – og resultatet oplyser, når dette er sket.
Kan jeg få Word i stedet?
Ja. Vælg Word i outputvælgeren, så genskabes scanningen som et redigerbart DOCX-dokument.
Er det gratis at prøve OCR?
Ja. Din første OCR-konvertering kan køres uden en konto.
Er der et vandmærke?
Nej. Den PDF, der kan søges i, får ikke et vandmærke.
Er eksemplet ovenfor ægte?
Ja. Det bruger det faktiske billede-til-dokument OCR-resultat, der vises på konverteringsfunktionens side.