PDF-এ OCR চালান যাতে প্রতিটি শব্দ অনুসন্ধানযোগ্য হয়
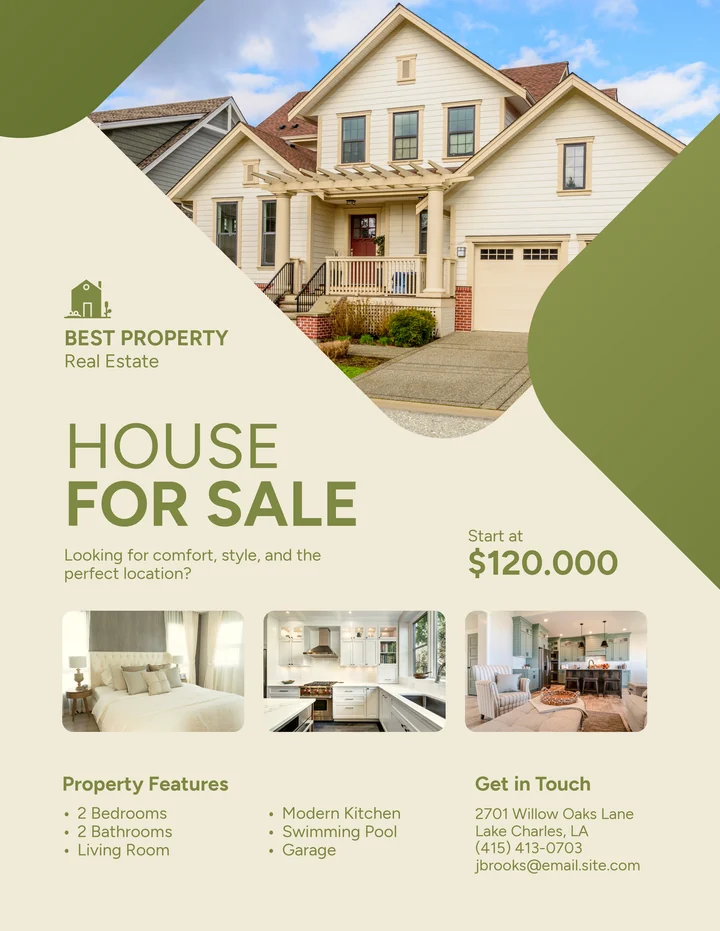
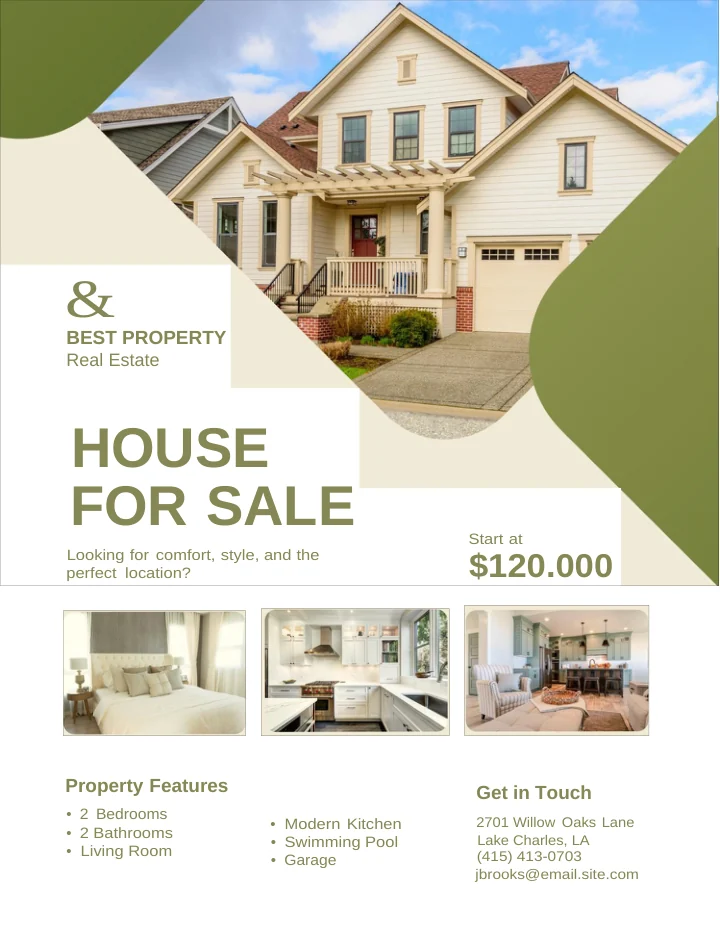
একটি স্ক্যান বা ছবি আপলোড করুন — OCR স্বয়ংক্রিয়ভাবে একটি অনুসন্ধানযোগ্য PDF তৈরি করে।
সাধারণ প্রশ্নাবলী
OCR একটি PDF-এর কী করে?
এটি স্ক্যান করা পৃষ্ঠার পেছনে একটি টেক্সট লেয়ার যোগ করে, ফলে পৃষ্ঠাটি মূল স্ক্যানের মতো দেখানোর পাশাপাশি আপনি শব্দ অনুসন্ধান, নির্বাচন এবং কপি করতে পারবেন।
আমি কি PDF-এর বদলে একটি ছবি আপলোড করতে পারি?
হ্যাঁ। JPG, PNG, TIFF, BMP এবং WebP ছবিগুলোকে PDF-এ রূপান্তর করে একই রানে OCR দিয়ে পড়া যায়।
আমার PDF-এর জন্য OCR প্রয়োজন কিনা তা আমি কীভাবে বুঝব?
একটি বাক্য নির্বাচন করার চেষ্টা করুন। যদি কিছুই হাইলাইট না হয়, তবে পৃষ্ঠাটি একটি ছবি। আপনাকে আগে থেকে সিদ্ধান্ত নিতে হবে না — রূপান্তর পাইপলাইনটি স্বয়ংক্রিয়ভাবে টেক্সট লেয়ার আছে কিনা তা পরীক্ষা করে।
ফলাফলটি কি সত্যিই অনুসন্ধানযোগ্য?
হ্যাঁ। এই পৃষ্ঠার গ্রহণযোগ্যতা পরীক্ষা শুধু একটি OCR টুল চলেছে বলে ধরে নেওয়ার বদলে তৈরি হওয়া PDF থেকে টেক্সট বের করে যাচাই করে।
এটি কি পৃষ্ঠাগুলির চেহারা বদলে দেবে?
দৃশ্যমান স্ক্যান করা পৃষ্ঠাটি যথাস্থানে থাকে এবং একটি অদৃশ্য টেক্সট স্তর যুক্ত করা হয়। হাতের লেখা, ঝাপসা বা খুব ছোট লেখার ক্ষেত্রে সনাক্তকরণ নিখুঁত না-ও হতে পারে।
PDF-টি কতটা বড় হতে পারে?
সর্বোচ্চ ১০ মেগাবাইট পর্যন্ত। ২০ পৃষ্ঠার চেয়ে দীর্ঘ নথিগুলো তাদের প্রথম ২০ পৃষ্ঠা পর্যন্ত প্রক্রিয়াজাত করা হয় — পেইড অ্যাকাউন্টে ১০০ পৃষ্ঠা — এবং সেটি কখন ঘটেছে তা ফলাফল প্রকাশ করে।
আমি কি এর বদলে Word ফাইল পেতে পারি?
হ্যাঁ। আউটপুট কন্ট্রোল থেকে Word বেছে নিন এবং স্ক্যান করা ফাইলটি একটি সম্পাদনাযোগ্য DOCX নথি হিসাবে পুনরায় তৈরি হয়ে যাবে।
OCR কি বিনামূল্যে চেষ্টা করে দেখা যাবে?
হ্যাঁ। আপনার প্রথম OCR রূপান্তর কোনো অ্যাকাউন্ট ছাড়াই চালিত হতে পারে।
এখানে কি কোনো ওয়াটারমার্ক থাকবে?
না। অনুসন্ধানযোগ্য PDF-এ কোনো ওয়াটারমার্ক থাকে না।
উপরের উদাহরণটি কি প্রকৃত?
হ্যাঁ। এটি কনভার্সন ফিচার পেজে দেখানো আসল ইমেজ-টু-ডকুমেন্ট OCR ফলাফল ব্যবহার করে।